Wer ChatGPT, Claude oder Gemini nutzt, gibt den Systemen häufig mehr Informationen, als ihm bewusst ist. Dazu können interne Dokumente, Geschäftsideen, Quellcode oder unveröffentlichte Forschung gehören. Ein aktueller Streit aus der Mathematik zeigt, warum man sich mit den Trainingseinstellungen der KI-Dienste beschäftigen sollte.
Kurz und aktuell (Stand: 9. Oktober 2026)
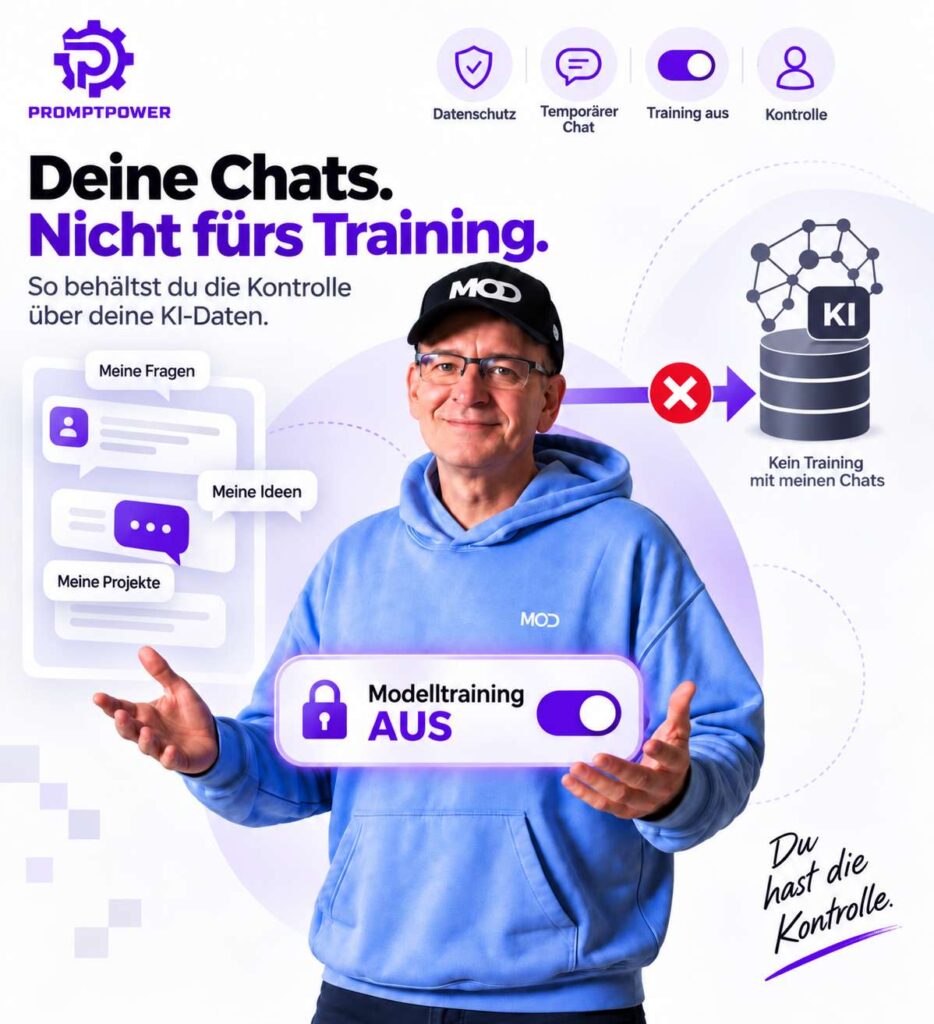
So schaltest du das Training mit deinen Chats aus:
- ChatGPT: Einstellungen → Datenkontrollen → „Das Modell für alle verbessern“ → AUS
- Claude: Einstellungen → Datenschutz → „Helfen Sie uns, unsere KI-Modelle zu verbessern“ → AUS
- Gemini: Einstellungen & Hilfe → Aktivitäten → „Aktiviert“ → „Deaktivieren“
Für einzelne vertrauliche Gespräche gibt es bei allen drei einen Chat ohne Training: den Temporären Chat bei ChatGPT und Gemini, den Inkognito-Chat bei Claude. Einschränkungen und Speicherfristen stehen unten.
Ein aktueller Fall zeigt das Problem
Andreas Thom, Professor für Geometrie an der TU Dresden, hatte über mehrere Monate gemeinsam mit einem Kollegen ChatGPT bei der Arbeit an laufenden mathematischen Forschungsfragen genutzt. Teile dieser Forschung waren noch nicht veröffentlicht.
Am 29. Juni 2026 deaktivierte er nach eigenen Angaben die Verwendung seiner ChatGPT-Inhalte zur Verbesserung der Modelle.
Anfang August stellte OpenAI einen KI-gestützten mathematischen Durchbruch aus der Gruppentheorie vor. Eine interne Version von Astra hatte eine zentrale Frage zu sogenannten nicht sofischen Gruppen beantwortet. Der Lösungsweg baute wesentlich auf Arbeiten des Mathematikers Gábor Kun sowie gemeinsamen Arbeiten von Kun und Thom auf.
Der Wissenschaftler fragte daraufhin OpenAI, ob seine früheren ChatGPT-Gespräche dabei eine Rolle gespielt haben könnten. Einen Beleg dafür gibt es bislang nicht. OpenAI bestreitet einen direkten Zugriff auf die betreffenden Unterhaltungen (Heise Online, 10. September 2026).
Der Fall macht allerdings einen wichtigen Unterschied sichtbar: Ein direkter Zugriff auf einen Chat und die vorherige Verwendung von Chat-Inhalten zur Verbesserung eines KI-Modells sind zwei verschiedene Vorgänge.
Genau deshalb lohnt sich ein Blick auf die Einstellungen der großen KI-Dienste.
Welche Informationen können überhaupt problematisch sein?
Bei KI und Datenschutz liegt der Fokus häufig auf personenbezogenen Daten. Im beruflichen Alltag können jedoch auch Informationen relevant sein, die überhaupt keinen Personenbezug enthalten.
Dazu gehören beispielsweise:
- unveröffentlichte Forschungsergebnisse
- Produktideen
- Geschäftsstrategien
- interne Marktanalysen
- noch nicht angemeldete Patente
- Quellcode
- Preisstrategien
- Kampagnenkonzepte
- Geschäftsgeheimnisse
Eine Anonymisierung oder De-Identifizierung hilft bei solchen Informationen nur begrenzt. Bei einer neuen mathematischen Methode, einer Produktidee oder einer Strategie kann gerade der Inhalt selbst wertvoll sein.
Wer regelmäßig mit generativer KI arbeitet, sollte deshalb prüfen, ob seine Unterhaltungen zur Verbesserung der jeweiligen Modelle verwendet werden dürfen.
ChatGPT: „Das Modell für alle verbessern“ ausschalten
Bei privaten ChatGPT-Konten lässt sich die Verwendung neuer Unterhaltungen zur Modellverbesserung deaktivieren. Der Weg führt über:
Kontomenü (Profilbild) → Einstellungen → Datenkontrollen → „Das Modell für alle verbessern“ → AUS → Fertig
In der App für iOS und Android: Seitenleiste öffnen → Profilsymbol → Datenkontrollen → „Das Modell für alle verbessern“ → AUS. Wer angemeldet ist, stellt das einmal für alle Geräte ein.
Die Unterhaltungen können weiterhin im Chatverlauf gespeichert werden. OpenAI erklärt jedoch, dass neue Gespräche nach dem Abschalten nicht zum Training seiner Modelle verwendet werden.
OpenAI: FAQ zu den Datenkontrollen in ChatGPT
Temporäre Chats für sensiblere Inhalte
ChatGPT bietet zusätzlich Temporäre Chats. Diese Unterhaltungen werden laut OpenAI nicht zum Training verwendet, erscheinen nicht im normalen Chatverlauf und erzeugen keine Erinnerungen. Aus Sicherheitsgründen kann OpenAI eine Kopie bis zu 30 Tage aufbewahren. Speicherst du einen temporären Chat, wird daraus ein normaler Chat, und für ihn gilt wieder deine Einstellung zur Modellverbesserung.
OpenAI: FAQ zum temporären Chat
Für ChatGPT Business, Enterprise, Edu und die API gelten andere Bedingungen. OpenAI verwendet Inputs und Outputs dieser Angebote standardmäßig nicht zum Training seiner Modelle.
OpenAI: Verwendung von Daten zur Verbesserung der Modelle
Wichtig bei älteren ChatGPT-Unterhaltungen
Das spätere Ausschalten der Modellverbesserung bedeutet nicht automatisch, dass frühere Unterhaltungen niemals für Trainingsprozesse verwendet worden sein können.
Genau deshalb ist der Zeitpunkt der Einstellung relevant. Wer ChatGPT beruflich nutzt, sollte die Modellverbesserung möglichst vor der Verarbeitung vertraulicher Informationen deaktivieren.
Claude: Verwendung für zukünftiges Training ausschalten
Auch Anthropic bietet bei Claude eine entsprechende Einstellung. Du erreichst sie über deinen Namen in der Seitenleiste:
Einstellungen → Datenschutz → „Helfen Sie uns, unsere KI-Modelle zu verbessern“ → AUS
Direkt erreichbar ist die Seite auch über claude.ai/settings/data-privacy-controls.
Anthropic erklärt, dass neue Chats und Coding-Sessions anschließend nicht für zukünftiges Modelltraining verwendet werden.
Bei Claude ist ein Detail interessant: Nach dem Abschalten sollen auch zuvor gespeicherte Chats nicht mehr für zukünftige Trainingsläufe verwendet werden. Bereits laufende Trainingsprozesse oder bereits trainierte Modelle lassen sich dadurch allerdings nicht rückwirkend verändern.
Die Einstellung entscheidet auch darüber, wie lange Anthropic Daten aufbewahrt: Ist die Modellverbesserung eingeschaltet, können neue Chats bis zu fünf Jahre in de-identifizierter Form in den Trainingsabläufen bleiben. Gelöschte Chats verschwinden sofort aus dem Verlauf und innerhalb von 30 Tagen aus den Systemen (Anthropic: Wie lange werden meine Daten gespeichert?).
Anthropic: Datenschutzeinstellungen zur Modellverbesserung
Inkognito-Chats bei Claude
Für Unterhaltungen, die nicht zur Modellverbesserung verwendet werden sollen, bietet Claude außerdem Inkognito-Chats. Diese werden unabhängig von der allgemeinen Trainingseinstellung nicht zur Verbesserung der Modelle verwendet.
Anthropic: Werden meine Daten für das Modelltraining verwendet?
Gemini: Aktivitäten speichern deaktivieren
Google organisiert die entsprechenden Einstellungen bei Gemini etwas anders. Der Schalter heißt nicht „Training“, sondern „Aktivitäten speichern“. Bei privaten Google-Konten findest du ihn unter:
gemini.google.com → Einstellungen & Hilfe → Aktivitäten → oben auf „Aktiviert“ → „Deaktivieren“
Google bietet dort außerdem die Möglichkeit „Deaktivieren und Aktivitäten löschen“.
Google erklärt, dass zukünftige Chats bei deaktivierter Speicherung nicht zur Verbesserung seiner generativen KI-Modelle verwendet werden.
Google: Aktivitäten in Gemini Apps verwalten und löschen
Auch bei deaktivierter Speicherung bleiben Unterhaltungen bis zu 72 Stunden mit dem Konto verknüpft, damit Google den Dienst bereitstellen und Feedback verarbeiten kann. In den Aktivitäten erscheinen sie dann nicht. Weitere Informationen zur Verwendung von Gemini-Daten für generative KI stellt Google hier bereit:
Google: Gemini-Daten und Verbesserung generativer KI
Temporäre Chats bei Gemini
Inzwischen gibt es auch bei Gemini einen Temporären Chat, im Web oben links neben „Neuer Chat“. Laut Google werden diese Chats nicht zum Training der KI-Modelle verwendet und 72 Stunden mit dem Konto gespeichert. Im Chatverlauf und in den Aktivitäten tauchen sie nicht auf.
Google: Gemini Apps Privacy Hub
Reicht das Ausschalten des Trainings?
Für viele private Anwendungen ist es eine sinnvolle Grundeinstellung. Im professionellen Umfeld sollte man sich darauf allein nicht verlassen.
Auch wenn ein Anbieter einen Chat nicht für das Modelltraining verwendet, werden die eingegebenen Informationen zunächst von einem externen Dienst verarbeitet. Je nach Anbieter, Tarif und Funktion können außerdem unterschiedliche Speicherfristen und weitere Datenverarbeitungen gelten.
Bei besonders sensiblen Informationen sollte deshalb geprüft werden, ob ein Consumer Account überhaupt das geeignete Werkzeug ist.
Business-, Enterprise- und API-Angebote können hier deutlich bessere Voraussetzungen bieten, weil die Verwendung von Eingaben vertraglich geregelt werden kann und die Anbieter teilweise zusätzliche Datenschutz- und Administrationsfunktionen bereitstellen.
Wenn der Schalter fehlt oder nicht greift
Findest du die Einstellung nicht oder scheint sie nicht zu wirken, steckt meist einer dieser Gründe dahinter:
- Firmen- oder Schulkonto: Bei ChatGPT Business, Enterprise und Edu, bei Claude für Teams und Unternehmen und bei Google-Workspace-Konten legt die Organisation die Datenregeln fest. Der Schalter fehlt dann oder lässt sich nicht ändern, bei Gemini steuert die Verwaltung der Organisation auch die Aktivitäten. Was für dein Konto gilt, weiß die IT-Abteilung.
- Anderes Konto oder ohne Anmeldung: Bei ChatGPT gilt die Einstellung für das ganze Konto und auf allen Geräten, aber eben nur für dieses Konto (OpenAI: Datenkontrollen in ChatGPT). Wer ein privates und ein berufliches Konto hat oder ChatGPT auch ohne Anmeldung nutzt, muss den Schalter dort jeweils eigens ausschalten.
- Bewertung per Daumen: Bewertest du bei ChatGPT eine Antwort mit Daumen hoch oder runter, kann OpenAI das ganze zugehörige Gespräch zur Verbesserung der Modelle verwenden, auch wenn das Training ausgeschaltet ist (OpenAI: Verwendung von Daten). Bei vertraulichen Gesprächen lässt du die Bewertung deshalb besser weg.
- Frühere Chats: Das Ausschalten wirkt bei ChatGPT und Gemini nur für neue Unterhaltungen, ältere können bereits verwendet worden sein (siehe oben).
Das gehört zur praktischen KI-Kompetenz
Die Trainingseinstellungen von ChatGPT, Claude und Gemini gehören aus meiner Sicht zu den Grundlagen, die Beschäftigte kennen sollten, wenn sie generative KI beruflich einsetzen.
Dabei geht es auch um die Einordnung der verwendeten Informationen. Wer im Marketing arbeitet, hat mit anderen vertraulichen Daten zu tun als Entwicklerinnen und Entwickler, eine Personalabteilung oder Forschende.
Das passt unmittelbar zum Ansatz der KI-Kompetenz nach Artikel 4 des EU AI Act. Welche Kenntnisse Beschäftigte benötigen, hängt vom konkreten Einsatzkontext der KI-Systeme und den damit verbundenen Risiken ab.
Eine allgemeine Einführung in ChatGPT kann dafür eine Grundlage schaffen. Für den professionellen Einsatz braucht es zusätzlich klare Regeln, welche Informationen in welchen KI-Diensten verarbeitet werden dürfen und welche Einstellungen dafür erforderlich sind.
Der aktuelle Streit aus der Mathematik liefert dafür ein anschauliches Beispiel. Die Datenschutzeinstellungen eines KI-Dienstes sollte man kennen, bevor vertrauliche Informationen im Chat landen.
Stand: 9. Oktober 2026. Menüpfade bei ChatGPT, Claude und Gemini an diesem Tag gegen die Hilfeseiten der Anbieter geprüft (erste Fassung: 12. September 2026). Den Abschnitt zu fehlenden Schaltern habe ich am 2. November 2026 ergänzt. Einstellungen, Bezeichnungen und Nutzungsbedingungen können sich ändern.
Überblick zu KI-Sicherheit, Daten und Unternehmen: Proprietäre Daten: Warum KI-Firmen jetzt für das bezahlen, was nicht im Netz steht.
Bevor Dateien im Chat landen: Wie du sie anonymisierst und welche Fallen in Word, PDF und Screenshots stecken, erklärt mein kostenloser Leitfaden Daten sicher für KI vorbereiten. Weitere Werkzeuge findest du unter Tools und Downloads.
Datenschutz gehört für mich zum Einstieg in KI dazu, nicht in ein Sonderkapitel am Ende. Einen praktischen Lernpfad dafür findest du auf KI lernen.